机器学习与数据挖掘 智能识别异常交易与欺诈行为的数据处理服务
在数字化金融时代,交易规模与复杂度呈指数级增长,传统的规则引擎已难以应对日益隐蔽的欺诈手段。通过机器学习和数据挖掘技术,人工智能能够从海量交易数据中自动识别异常模式,为数据处理服务注入智能基因,实现实时、精准的欺诈行为检测。
一、异常交易识别的核心挑战
异常交易往往伪装成正常行为,具有低频、多变、对抗性强的特点。传统方法依赖人工设定阈值(如单笔金额超过5000元则预警),但欺诈者可以通过拆分金额、模仿正常用户节奏来绕过规则。正常交易的多样性(如节假日促销、突发的出差消费)会造成大量误报,让风控人员疲于奔命。
二、机器学习如何赋能异常检测
机器学习模型能够从历史交易数据中自动学习正常与异常的行为边界。常用的方法包括:
- 监督学习:利用已标注的欺诈交易样本训练分类器(如XGBoost、随机森林),预测新交易的风险概率。
- 无监督学习:在缺乏标签时,使用孤立森林(Isolation Forest)、自编码器(Autoencoder)或聚类算法(如DBSCAN)发现偏离群体模式的离群点。
- 半监督学习:结合少量标签和大量未标签数据,通过PU学习(正例-未标签学习)提升检测覆盖率。
- 序列模型:针对交易时序,使用LSTM、GRU或Transformer捕捉用户行为习惯的突变,例如突然的异地大额转账。
三、数据挖掘的关键步骤
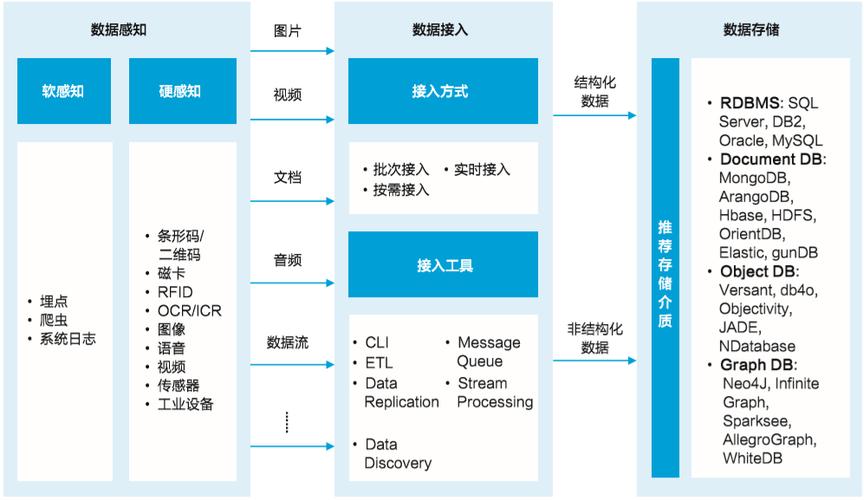
数据处理服务包括数据清洗、特征工程、模型训练与部署:
- 数据清洗:处理缺失值、去重、纠正时间戳,构建用户-商户-设备-IP的多维关系网络。
- 特征工程:生成统计特征(如近1小时交易频次、平均金额)、时序特征(如消费周期性)和图特征(如与已知欺诈账户的关联度)。
- 模型训练:利用历史数据交叉验证,采用代价敏感学习解决类别不平衡问题,并引入SHAP值提升解释性。
- 在线部署:将模型封装为API,以流式计算(如Flink、Kafka)实时打分,毫秒级响应。
四、典型应用场景
- 信用卡反欺诈:识别盗刷、批量注册、虚假申请。
- 电商风控:检测刷单、黄牛抢购、恶意退款。
- 洗钱监测:发现拆分转账、多层嵌套交易。
- 账户盗用:基于登录地点、设备指纹和行为生物特征识别异常登录。
五、数据处理服务的价值与趋势
通过AI驱动的异常检测,企业可将欺诈损失降低30%-70%,同时减少人工审核成本。未来趋势包括:
- 联邦学习:在保护隐私的前提下跨机构联合建模风控。
- 图神经网络:深度挖掘交易网络中的团伙欺诈。
- 自适应学习:模型在线更新,对抗概念漂移(欺诈手段演变)。
- 可解释AI:满足监管要求,让每个预警都有据可查。
机器学习与数据挖掘技术正在重塑异常交易识别与欺诈检测的范式。数据处理服务不再是简单的ETL,而是融合特征工程、模型推理和实时决策的智能引擎。拥抱这一技术,金融机构与电商平台能够在保障用户体验的构筑动态、精准、自适应的风控防线。
如若转载,请注明出处:http://www.gxxndz.com/product/38.html
更新时间:2026-10-15 15:36:05